Qwen3.6-35B на одній відеокарті з 12 ГБ: найкраще 48.7% на всіх 300 інстансах SWE-bench Lite
Зміст
Канонічна URL: https://synenergy.ai/research/swebench-lite-300-local-35b (цитуйте за цією адресою).
Що ми виміряли
Ми прогнали кодувального агента по SWE-bench Lite, усіх 300 інстансах — на цілому спліті, не на
вибірці. Список інстансів заморожено як маніфест swebench_lite_300.txt, sha256
6b9850decb64f71aaed19d394195eb254b666a4abe7f113365195b3e4de2b450, опублікований разом із
квитанціями (receipts), щоб будь-хто міг переконатися: набір задач не курували заднім числом.
Модель — локальна Qwen3.6-35B-A3B, Q4_K_XL, яку обслуговує llama-server на одній
RTX 4070 SUPER з 12 ГБ VRAM. Нічого не відправлялося до хостованого API. Ширвжиткове залізо —
частина результату: це один настільний GPU, не кластер. Агент — відкритий mini-swe-agent
(2.4.6) з одним інструментом bash, плюс додатки, які описано для кожного арму нижче.
Два числа, разом, бо повідомити лише одне з них було б вибором, якого ми робити не хочемо:
- Базова лінія (рука A): 135 / 300 = 45.0%.
- Найкраще втручання (рука B): 146 / 300 = 48.7%.
Знаменник — 300 у кожному числі цього допису. Його зафіксували письмово до запусків, і він не рухається: «Знаменник — 300, що б не сталося. Інстанс, який упав, був пропущений або не стартував, рахується як НЕ розв'язаний». Ми ніколи не повідомляємо розв'язані-до-оцінених. Руки втратили різну кількість інстансів через інфраструктуру оцінювання, і знаменник на кожну руку тихо нагороджував би ту руку, яка втратила менше.
Зауваження про те, як зібрано цей допис, бо це частина того, що ми стверджуємо. П'ять чисел,
які ми початково мали намір опублікувати, не витримали звірки з нашими ж замороженими файлами —
і це п'ять випадків одного механізму: реальне вимірювання, процитоване в контексті, з якого воно
не походить. Одне — ~7,166 completion-токенів на задачу — було обчислене по хибній
популяції: воно близьке до середнього по 225 задачах зі статусом Submitted, а не по всіх 300,
де середнє — 11,107, а медіана — 7,092. Одне — контроль на запам'ятовування на 30 інстансах —
було обчислене по підмножині, якої, як з'ясувалося, не існує: не збереглися ні скрипт, ні seed,
ні список id, і його замінено на всі 88 оцінюваних нерозв'язаних-але-пропатчених інстансів.
Одне — і наш запис уже не каже, яка саме з двох величин це була: пара вирізаних показників VRAM,
які тут не наводяться, бо ніщо в дереві доказів їх не дає, або показники таймінгу, приписані
підмножині з 285 інстансів, якої не існує — не вдалося простежити до вимірювання, якому його
приписали. Одне — середнє запам'ятовування, 0.351 — було невідтворюваним за доказами і
змістилося до 0.3484, коли його перерахували від початку до кінця. І одне — сходинка
конкурентності, 1.74x сумарного масштабування — було прогрівальною пробою, підписаною як
стала пропускна здатність; виміряне на реальному навантаженні масштабування становить
1.15x до 1.31x. У жодному з цих п'яти випадків число не було вигадане. Саме в цьому суть, і це
корисніша половина допису: режим відмови, який переживає уважних людей, — не фабрикація, а
правильне число, перенесене через межу, за якою воно не тримається. Кожне було виправлене або
вирізане до публікації; повна диспозиція кожного — у UNVERIFIED.md. Шосту величину
також відкликано — твердження про бюджет кроків, і це той самий механізм ушосте, а не дефект
іншого роду — викладено нижче, під «Виклики моделі на задачу». Ще одна величина — колонка
«evaluated» зі значенням 229 для руки A, яка насправді є кількістю поданих (submitted) руки
D-1 — схибила так само, але її спіймали на звірці із замороженими файлами ще до того, як вона
дійшла до цього допису, тож серед чисел, які цей допис мусив відкликати, вона не рахується.
Саме для цього й потрібні квитанції — число, яке ви не можете простежити назад до файлу, не є
результатом, а число, яке простежити можна, все одно мусить бути простежене до правильного
файлу.
Одне треба сказати, перш ніж хтось потягнеться за порівнянням: 45.0% тут — це на Lite. Більшість величин, які публікують у полі, стосуються SWE-bench Verified, іншого спліту з іншими інстансами, і з нашими вони не порівнянні. Що Lite таки дозволяє порівняти — у наступному розділі, разом з обмеженнями.
Як це виглядає поруч з іншими
Першим, з чим захочеться порівняти, буде публічна таблиця лідерів SWE-bench Lite. Нижче — вибірка з неї разом з умовами, через які більша частина цих рядків не є порівнянням рівного з рівним.
| Система | Модель | Відкриті ваги | Розмір · залізо | Спроби | Lite % | Джерело |
|---|---|---|---|---|---|---|
| ExpeRepair v1.0 | Claude 4 Sonnet + o3-mini/o4-mini | ні | не розкрито | 2+ | 60.33 | таблиця |
| Refact.ai Agent | Claude 3.7 Sonnet + o4-mini | ні | не розкрито | 1 | 60.00 | таблиця |
| SWE-agent | Claude 4 Sonnet | ні | не розкрито | 1 | 56.67 | таблиця |
| EntroPO + R2E | Qwen3-Coder-30B-A3B, дотренована | лише базова | 30.5B, 3.3B активних | best-of-16 | 49.67 | таблиця |
| Цей допис, рука B | Qwen3.6-35B-A3B, Q4_K_XL | так | 35B, 3B активних · одна RTX 4070 SUPER, 12 ГБ | 1 | 48.7 | цей допис |
| ai-muninn | Qwen3.6-35B-A3B, FP8 | так | 35B, 3B активних · DGX Spark, 128 ГБ | 1 | 48.33 | блог, не в таблиці |
| SWE-agent | Claude 3.7 Sonnet | ні | не розкрито | 1 | 48.00 | таблиця |
| Цей допис, рука A | Qwen3.6-35B-A3B, Q4_K_XL | так | 35B, 3B активних · одна RTX 4070 SUPER, 12 ГБ | 1 | 45.0 | цей допис |
| EntroPO + R2E | Qwen3-Coder-30B-A3B, дотренована | лише базова | 30.5B, 3.3B активних | 1 | 45.00 | таблиця |
| CodeFuse-CGM | CGM на базі Qwen2.5-72B | так | 72B щільна | 2+ | 44.00 | таблиця |
| OpenHands CodeAct 2.1 | Claude 3.5 Sonnet | ні | не розкрито | не позначено | 41.67 | таблиця |
| KGCompass | DeepSeek-V3 | так | 671B, 37B активних | 2+ | 36.67 | таблиця |
| SWE-agent | SWE-agent-LM-32B | так | 32B щільна | 1 | 30.7 | стаття, не в таблиці |
| Moatless Tools | DeepSeek-V3 | так | 671B, 37B активних | не позначено | 30.67 | таблиця |
| Moatless + верифікатор | SWE-Gym-32B | так | 32B щільна | best-of-k | 26.0 | стаття, не в таблиці |
| SWE-Fixer | Qwen2.5 7B + 72B, дотреновані | так | 7B + 72B щільні | 1 | 24.67 | таблиця |
† «Таблиця» — офіційна таблиця лідерів SWE-bench Lite; «не позначено» — таблиця не вказує кількість спроб. Власний README EntroPO наводить 134/300 і 148/300 для двох записів, на один інстанс менше за кожну цифру таблиці; показано цифри таблиці. ai-muninn.com, 2026-04-20, mini-swe-agent із трьома доданими правилами, один прогін. Статті: SWE-smith (arXiv 2504.21798), SWE-Gym (arXiv 2412.21139).
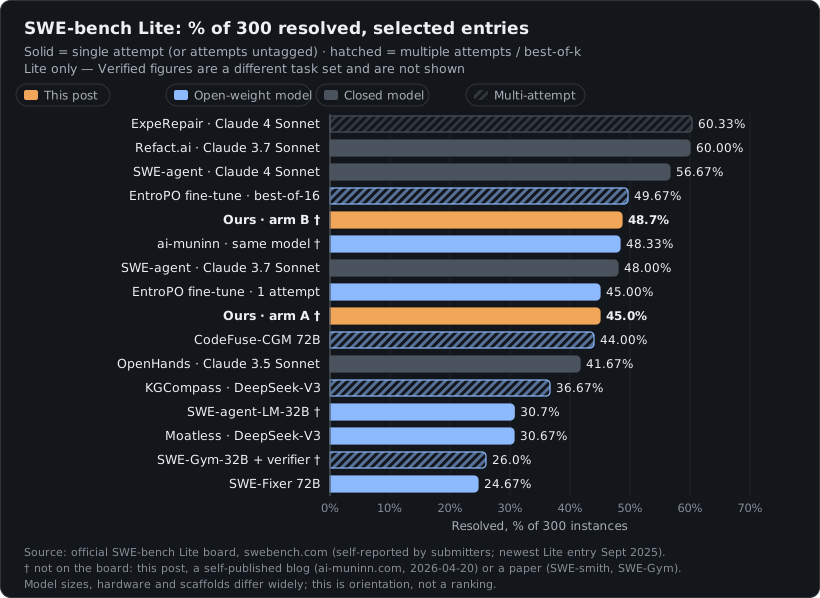
Чотири речі обмежують те, що ця таблиця може сказати.
Таблицю заповнюють самі автори, і вона більше не оновлюється. Записи подають їхні ж автори, найновіший запис на Lite датований вереснем 2025 року, а провідні лабораторії тепер звітують лише на SWE-bench Verified. Це знімок 2024–2025 років, а не нинішній стан справ.
Спроби не взаємозамінні. Запис із кількома спробами чи best-of-k обирає з кількох патчів на задачу; у нас — одна спроба на інстанс. EntroPO показує, наскільки це важить на моделі з 3B активних параметрів: 45.00 з однією спробою, 49.67 — із шістнадцятьма.
Відкриті моделі тут різняться розміром на два порядки — від щільної 7B до 671B із 37B активних, здебільшого на нерозкритому залізі.
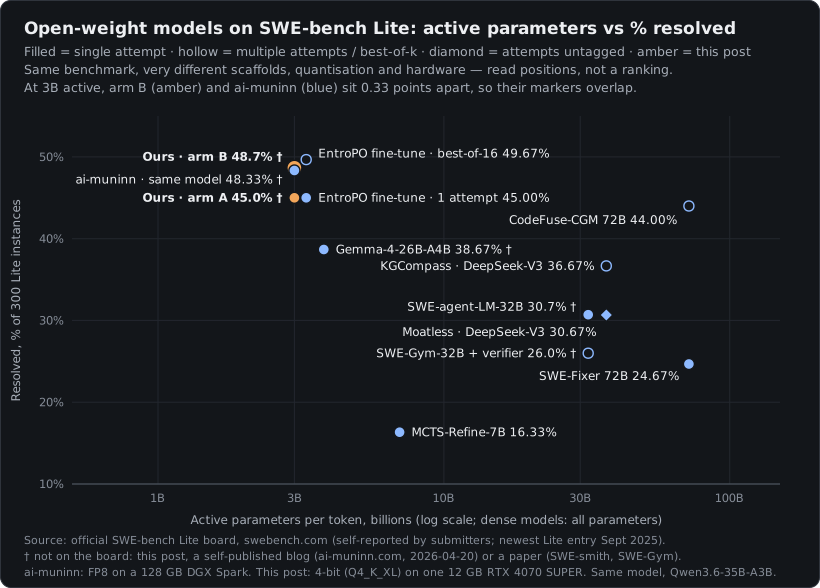
Verified на цю вісь не потрапляє. Картка моделі від Qwen наводить для цієї ж моделі 73.4% на Verified із власним каркасом Qwen; це інший набір інстансів, і ми його не відкладаємо на графіку. До того ж цифри виробників на Verified помітно вищі за незалежні прогони тих самих моделей: GLM-4.5 — 64.2 проти 54.2, Devstral 2 — 72.2 проти 53.8, gpt-oss-120b — 62.4 (на підмножині з 477 інстансів) проти 26.0. Розрив — від 10 до 36 пунктів.
Після всіх цих обмежень лишається небагато. Найближче порівняння — та сама модель. Незалежний прогін Qwen3.6-35B-A3B у FP8 на DGX Spark із 128 ГБ розв'язав 145 із 300 (48.33%) — один прогін, опублікований автором самостійно, не в таблиці лідерів. 146 руки B — на одному рівні з ним: один інстанс лежить у межах варіації між запусками, якої ми не вимірювали. 135 руки A відрізняється від того прогону водночас квантизацією (4 біти проти 8), залізом (одна споживча GPU на 12 ГБ проти робочої станції на 128 ГБ) і каркасом агента, тож різницю в десять інстансів не можна приписати жодному з цих чинників окремо. Обидва прогони використовують того самого відкритого агента, mini-swe-agent: у них до нього додано три правила (строгий формат команд, інструмент правки, що замінює рівно один збіг, і підказку здати рішення до 60-го кроку зі 100), у нас — обробку зациклення, описану нижче. Жодного з їхніх трьох правил немає в жодній нашій руці.
Передреєстрована планка
Передреєстрація назвала одну первинну метрику і назвала її повністю: «кількість розв'язаних із 300, на ідентичному шляху оцінювання, що й рука A.» Обидві половини цієї фрази — умови, які ми поставили собі до запуску будь-якої руки: знаменник і шлях оцінювання. Рука D порушує другу половину, як викладено у блоці під таблицею.
Передреєстрація для руки B, написана до старту того запуску, наперед прогнозувала, що рука B розв'яже більше, ніж 135/300 (45.0%) руки A, і зобов'язувалася: «Результат на рівні 135 або нижче — це реальний результат, і його буде повідомлено як такий».
Отже, 135 було планкою для руки B. Рука B дала 146, подолавши її. Цей результат — 146 — далі став планкою, яку мусили перевершити пізніші руки. Рука C і рука D її не перевершили.
Ми також наперед зобов'язалися до арифметичного правила вибування: рука мертва щойно її кількість розв'язаних плюс її ще не оцінені інстанси не можуть досягти чинного найкращого результату, незалежно від того, як міг би скластися залишок.
Таблиця
| Рука | Втручання | Розв'язано / 300 | % |
|---|---|---|---|
| A | базова лінія | 135 | 45.0% |
| B | ресемплінг, коли команда повторюється | 146 | 48.7% |
| C | контекстне втручання при блокуванні | 132 | 44.0% |
| D-1 † | C з відкладеним початком (налаштування 1) | 128 | 42.7% |
| D-2 † | C з відкладеним початком (налаштування 2) | 120 | 40.0% |
† нижня межа, не порівняння рівного з рівним — див. нижче.
Дві речі, які треба читати разом із цією таблицею, а не після неї.
1. Руки відрізняються не лише втручанням. Рука A працювала на одному воркері; рука B — на
чотирьох. Передреєстрація декларує це заздалегідь, а не виявляє потім: «Рука B працює на 4
воркерах проти одного llama-server із 4 слотами; рука A працювала на 1 воркері». Конкурентність —
задекларований конфаунд у порівнянні A проти B, і розрив у +11 інстансів треба читати з огляду на
це. Що конкурентність насправді дає на цьому залізі — і виправлення показника пропускної
здатності, наведеного в попередній внутрішній чернетці — є нижче, у розділі «Пропускна здатність
обслуговування і виправлення попередньої чернетки», з виведенням у receipt_staircase.md.
A проти B лишається головним порівнянням, бо саме воно передреєстроване: рука A — контроль, рука B — втручання. B проти C — порівняння двох втручань без контролю всередині, тож воно нічого не може сказати про покращення відносно базової лінії. Воно каже лише одне, і ми формулюємо це рівно з такою силою: ресемплінг розв'язав на 14 інстансів більше, ніж контекстне втручання (146 проти 132).
Два незалежні свідчення кажуть, що приріст купила не кількість воркерів.
(i) Контрольний запуск на одному воркері. Ми перезапустили фіксовану підмножину з 35 інстансів
на одному воркері, проти передреєстрованого списку інстансів, чия контрольна сума була
записана на старті запуску (0089b36d…, 35 id, запуск COMPLETE на 35/35). На цій самій
підмножині контроль на одному воркері розв'язав 8, і рука B на чотирьох воркерах теж розв'язала
8 — та сама кількість, причому 6 із 8 — ті самі інстанси, і кожен запуск розв'язав по два,
яких не розв'язав інший. Ті два, які розв'язав контроль, а рука B ні, — це
matplotlib__matplotlib-25079 і matplotlib__matplotlib-25311; ті два, які розв'язала рука B, а
контроль ні, — mwaskom__seaborn-3407 і sympy__sympy-21379. Шість спільних інстансів —
astropy__astropy-12907, django__django-14580, scikit-learn__scikit-learn-11281,
scikit-learn__scikit-learn-15512, sympy__sympy-18532 і sympy__sympy-23262 — відновлені
перетином записів оцінювання обох запусків по 35 id і перелічені у квитанціях, тож усі вісім із
кожного боку можна перевірити, а не брати на віру з наших слів. На цій підмножині робота на
чотирьох воркерах не купила нічого.
(ii) Чотири воркери не допомогли руці C. Рука C теж працювала на чотирьох воркерах і опинилася нижче за одноворкерну руку A: 132 проти 135. Хоч би що робили чотири воркери, вони вочевидь не роздають розв'язані інстанси самі по собі.
Як відбирали ці 35 і чому одне число тут нічого не доводить. Підмножина задокументована, і документація дискваліфікує частину її: список інстансів — це зациклені (loop-locked) невдачі руки A, тобто 35 задач, на яких базова лінія застрягла, повторюючи саму себе. Тому рука A розв'язала 0 із цих 35 за побудовою, а не за вимірюванням, і ми не повідомляємо цей 0 як результат. Що переживає відбір — це порівняння, якого відбір не торкається: контроль на одному воркері й рука B на чотирьох воркерах пройшли ідентичні 35 інстансів, тож їхні 8 проти 8 — рівне з рівним, незалежно від того, як обрали ці 35.
Але відбір усе одно обмежує те, на що ці 8-проти-8 можна узагальнювати, і обмеження жорсткіше, ніж натякає «мала підмножина». Ці 35 — не випадкова вибірка з бенчмарку; це задачі, на яких базова лінія зациклилася — саме той режим відмови, проти якого будувалося втручання руки B, і саме та популяція, де ефект втручання мав би бути найбільшим, а ефект кількості воркерів — не обов'язково. Результат, який показує, що кількість воркерів не купила нічого тут, не переноситься на інші 265 інстансів, де суміш задач інша й жодного такого відбору не застосовували. Ми не запускали одноворкерний контроль на випадковій підмножині, а саме цього контролю цей аргумент насправді потребує. 35 із 300 — це мала підмножина: вона звужує конфаунд конкурентності на одному невипадковому зрізі бенчмарку, вона його не усуває, вона не поширюється на спліт у цілому, і ми не стверджуємо ні того, ні іншого.
Передреєстрація також задала розтяжку (tripwire) для конкурентності: якщо будь-яка задача руки B завершиться по стелі часу (wall cap), конкурентність стала конфаундом, і кожну таку задачу треба перелічити. Розтяжка спрацювала. П'ять задач руки B завершилися по стелі часу 4500 с:
django__django-11019, django__django-13710, matplotlib__matplotlib-25311,
pytest-dev__pytest-11148, sympy__sympy-19254.
У руки A було нуль. У руки C — три: django__django-11019,
pytest-dev__pytest-9359, pytest-dev__pytest-11148 — і в кожного налаштування руки D було по два:
у D-1 django__django-11019 і django__django-15202, у D-2 pytest-dev__pytest-11148 і
sympy__sympy-20049. Передреєстрована розтяжка покривала лише руку B, тож id рук C і D не були
перелічені, коли розтяжку писали; їх відновили згодом із того самого поля кожного запуску, яке дає
п'ять для руки B, і тепер усі десять перелічені у квитанціях і перевіряються там.
Прогноз, що стелі часу не буде досягнуто, виявився хибним, і ми фіксуємо його як хибний, а не
викидаємо перевірку. Зверніть увагу на напрямок, який це вказує: стеля часу спрацювала 5 разів у
руці B, 3 у руці C і по 2 в кожному налаштуванні руки D — усе це чотириворкерні руки — і 0 разів в
одноворкерній руці A. За цими даними конкурентність коштувала задач, а не завищувала
результат — якщо на те пішло, вона працювала проти руки B. Це прочитання — напрямок, а не
величина: 10 задач по стелі часу на чотири руки — заміло, щоб приписати цьому розмір, і руки
відрізняються втручанням так само, як кількістю воркерів, тож кількість спрацювань стелі не можна
приписати самій лише конкурентності.
2. Оцінювання руки D схибило, і ця відмова — не одна річ. Руки A, B і C оцінювалися по одному
інстансу за запуск і були оцінені на всіх 300 нашим власним пер-інстансним оцінювачем;
руку D оцінювало інше програмне забезпечення — штатний масовий harness SWE-bench
run_evaluation — тож
руки не проходили через один ідентичний шлях оцінювання, а це саме та умова, яку називає
передреєстрована первинна метрика: «на ідентичному шляху оцінювання, що й рука A», записана до
запусків, а не вигадана потім, щоб знецінити незручний результат. При масовому оцінюванні
рука D втратила 22 інстанси в D-1 і 24 в D-2, з двох різних причин. Більша частина — образи
середовища, які не збираються на нашій машині: три образи середовища SWE-bench —
sweb.env.x86_64.7037e8c4…, sweb.env.x86_64.31244378… і sweb.env.x86_64.efa6065e…,
усі на базі matplotlib — кожен аварійно завершується у conda на Solving environment з кодом 134,
і кожен інстанс, що від них залежить, падає з «Environment image not found» (16 інстансів у D-1,
18 у D-2). Решта шість у кожному налаштуванні були втрачені через зовсім іншу відмову: образ
оцінювання для конкретного інстансу не збирався, бо падає власний крок встановлення репозиторію —
no such option: --no-use-pep517 для чотирьох (D-1) і трьох (D-2) інстансів scikit-learn, і
відсутній у build-бекенді хук PEP 660 build_editable для двох (D-1) і трьох (D-2) інстансів
pylint. Рука D-1 завершила оцінювання на 207 із 300, а D-2 — на 210 із 300; решта завершилися з
помилкою. Втрачені інстанси — не випадкова вибірка: вони припадають на три репозиторії,
matplotlib (16 у D-1, 18 у D-2), scikit-learn (4 і 3) та pylint (2 і 3) — тож нижня межа зміщена
за репозиторіями, а не просто проріджена. Дві несправності накладаються і не розділяються: про
зміну оцінювача ми можемо сказати найменше, бо ми не встановили, що штатний масовий harness і наш
власний пер-інстансний оцінювач узгоджуються на тих інстансах, які обидва змогли оцінити, — тож немає
виміряної підстави вважати 207 чи 210 оцінених результатів руки D порівнянними з 300 у рук A, B і
C навіть після того, як відкласти вбік відсутні інстанси. Втрачені інстанси таки названі:
повні списки id для обох налаштувань, із зазначенням причини навпроти кожного, є у квитанціях
(arm_results.md), відновлені з власних записів помилок оцінювача. Тому числа руки D — це
нижня межа і вони не є порівнянням рівного з рівним з A, B і C. Це дефект нашого вимірювання, а
не властивість руки D, і чесне резюме таке: рядок руки D належить у таблиці як невдала рука, а
її точні числа не слід цитувати як вимірювання чого б то не було. Ми пишемо це поруч із
таблицею, а не у виносці, бо число, чиї слабини закопані, — це маркетингове число.
Як читати цей допис. Таблиця вище — це результат, а дві речі, які кваліфікують порівняння — руки відрізняються кількістю воркерів так само, як втручанням, і оцінювання руки D схибило — це два блоки вище. Далі, по порядку: негативний контроль, передреєстрована невдача руки D, вторинні показники, перевірка на запам'ятовування і найсильніший одиничний підозрюваний, де насправді втрати, анатомія таймінгу і наостанок розділ про пропускну здатність обслуговування, який виправляє показник із попередньої внутрішньої чернетки цього допису. Кожен розділ повністю викладає власні обмеження поруч із тим, що вони кваліфікують; квитанції несуть виведення.
Негативний контроль, рука A: три партії негативного контролю, п'ять no-op оцінювань на
чотирьох інстансах, усі з нульовим результатом. Ці чотири інстанси — django__django-17087,
sympy__sympy-20212, astropy__astropy-14182 і astropy__astropy-14995. Запуск, який не мав би
розв'язати нічого, не розв'язав нічого. («3» — це кількість партій, а не інстансів, і ми це
кажемо, бо інакше це читалося б як розмір вибірки.) Кожен каталог оцінювання несе власну трійку
негативного контролю на іншому наборі інстансів, тож ця величина належить руці A і жодній іншій
руці.
На чотирьох інстансах цей контроль слабкий, і саме називання їх робить це видимим. Він може зловити грубо поблажливого оцінювача — такого, що зараховує розв'язання з причин середовища чи обліку, — і він не спрацював. Він не має сили обмежити низьку частоту хибнопозитивних, чотири інстанси з 300 — це не вибірка, з якої щось випливає про інші 296, два з чотирьох походять з одного репозиторію, і для рук B, C і D ми не запускали жодного негативного контролю. Правильне прочитання таке: шлях оцінювання пройшов димову перевірку, а не був валідований.
Невдача
Рука D не виконала свою передреєстровану умову. Налаштування з пізнішим початком дало гірше, а не краще.
Вибування було арифметичним, а не судженням. За налаштування 2 (D-2): 120 розв'язаних плюс 24 так і не оцінених успішно дає стелю 144, нижче за 146 — мертва відразу. За налаштування 1 (D-1) рука формально лишалася відкритою (128 плюс 22 неоцінених = стеля 150), але щоб дійти до 146, знадобилася б 86% частка розв'язань на відсутній підмножині проти 62%, спостережених деінде. Ми закрили драбину там, замість витрачати ще тиждень на гонитву за результатом, який уже наперед зобов'язалися називати невдачею.
Дві з трьох родин втручань, які ми спробували, зробили гірше. Одна допомогла. Ми повідомляємо про всі.
Один прохід переоцінювання і що це було
Передреєстрація анулює порівняння, якщо «будь-який інстанс перезапускається індивідуально після першої спроби». Це правило не було порушене, і ми це перевірили, а не припустили.
Після того як масове оцінювання руки D завершилося з помилками — у D-1 на 16 інстансах з образами
середовища і на 7, де натомість не зібрався образ оцінювання конкретного інстансу (шість,
втрачених через власний крок встановлення репозиторію, плюс astropy__astropy-14995), усього 23;
у D-2 — на 24 — ми зробили другий прохід рівно по цих 23 (D-1) і 24 (D-2) інстансах. Цей прохід
повторно подав оцінювачу вже створені патчі, побайтово ідентичні тим, що в оригінальних
файлах передбачень. Агента не перезапускали; жодного нового патча не згенеровано. Другий
прохід відновив рівно один інстанс для D-1 — astropy__astropy-14995, чий образ оцінювання
зібрався з другої спроби — і нуль для D-2; решта 22 в D-1 і всі 24 в D-2 знову завершилися з
помилками з тих самих причин, що й раніше. Отже, 23 — це кількість помилок у D-1 до
повторної спроби, а 22 — кількість після, і саме ці 22 означає «втрачено» в нижній межі
таблиці. Так само 128 у руки D-1 — це 127 із першого проходу оцінювання плюс той один
відновлений інстанс, на 206 + 1 = 207 оцінених.
Переоцінювання наявного передбачення — це не перезапуск інстансу, тож порівняння лишається чинним. Це все одно відхилення від позиції «жодного переоцінювання», якій ми віддали б перевагу, і воно тут зафіксоване, а не тихо вбудоване.
Вторинні показники
Передреєстрація вимагала повідомити три показники поруч із кількістю розв'язаних, а «не замість неї». Усі три, по кожній руці:
Суміш статусів завершення (як завершився запуск агента, до оцінювання):
| Рука | Submitted | LoopLocked | LimitsExceeded | Стеля часу | Порожній патч |
|---|---|---|---|---|---|
| A | 225 | 35 | 40 | 0 | 1 |
| B | 244 | 4 | 47 | 5 | 0 |
| C | 212 | 58 | 27 | 3 | 0 |
| D-1 | 229 | 26 | 43 | 2 | 0 |
| D-2 | 237 | 14 | 47 | 2 | 0 |
Втручання зробило те, на що було спрямоване: 35 зациклених задач руки A падають до 4 у руці B.
Вони не всі стають розв'язаннями — LimitsExceeded зростає з 40 до 47 — але конкретна відмова, на
яку було націлене втручання, значною мірою зникає.
Виклики моделі на задачу, розв'язані проти нерозв'язаних:
| Рука | Медіана (розв'язані) | p95 (розв'язані) | Медіана (нерозв'язані) | p95 (нерозв'язані) |
|---|---|---|---|---|
| A | 35 | 86 | 59 | 120 |
| B | 37 | 95 | 71 | 150 |
| C | 39 | 77 | 52 | 150 |
| D-1 | 36 | 104 | 56 | 150 |
| D-2 | 36 | 94 | 65 | 150 |
Відкликання належить сюди насамперед. Попередня чернетка цього допису описувала ту саму величину іншим набором чисел: медіана 36 викликів моделі, p99 113, максимум 122 і величина 137, описана як «на стелі». Усі чотири відкликано, і причина — той самий механізм, що й у п'яти вище, а не новий. Усі чотири справді перераховуються з власних траєкторій руки A — але попередні величини вимірювали іншу величину на задачу, а не ту кількість кроків, до якої застосовується стеля; перераховані з кількості кроків, вони читаються як 35 / 108 / 110 / 120. Отже, 137 неможливе лише як кількість кроків, і воно ніколи нею й не було; це реальне вимірювання однієї величини, процитоване як інша. Наведена тут таблиця p95 заміняє ті числа й перерахована з кількості кроків у файлах траєкторій.
Це вимірювання спростовує «просто підніміть бюджет кроків». У кожній руці задачі, які розв'язуються, роблять це з медіаною десь у середині 30-х за викликами моделі, тоді як задачі, що зазнають невдачі, сидять на стелі або впираються в неї — p95 нерозв'язаних дорівнює рівно налаштованому ліміту (120 для руки A, 150 для решти). Задачі, які мали намір завершитися успіхом, завершувалися задовго до стелі. Ті, що на стелі, не були майже дороблені; вони застрягли. Підняття стелі зі 120 до 150 між рукою A і рукою B узагалі не змістило розподіл розв'язаних задач.
Метрика запам'ятовування повністю наведена нижче. Її обчислено на множині розв'язаних руки A; ми не перераховували її по кожній руці, тож твердження, що приріст руки B не є збільшеним копіюванням, не підкріплене вимірюванням по руках, і ми його не робимо.
Перевірка на запам'ятовування
Показник 45% на публічному бенчмарку напрошується на очевидне запитання: чи не запам'ятала модель виправлення? Ми виміряли recall доданих рядків кожного прийнятого патча проти золотого патча, на руці A.
Спершу два розкриття, бо це чесна частина цього розділу.
Метрику перевиведено, а не відновлено. Ні скрипт обчислення, ні збережений вивід оригінального
проходу не збереглися. Ми перерахували її із заморожених файлів передбачень і кешованих золотих
патчів, і ми публікуємо перевиведення як придатний до запуску скрипт разом із його виводом по
кожному інстансу: memorisation/added_line_recall.py та
memorisation/armA_added_line_recall_per_instance.csv, по одному рядку на кожен із 224
інстансів, що дали патч. Цей скрипт і цей CSV є авторитетом для цієї метрики — кожна величина
нижче перераховується з них, і там, де цей текст і CSV розходяться, перемагає CSV.
Одна величина в процесі змістилася, і треба сказати все, що це означає. Наш власний
попередній запис давав середнє 0.351. Ця величина невідтворювана за нашими доказами, і ми
публікуємо 0.3484. Повторний прогін від початку до кінця також виявив, що наше ж перше
перевиведення змішало два варіанти визначення — дедубльовані золоті рядки для знаменника
recall, сирі золоті рядки для підрахунку однорядкових золотих патчів; вибір недедубльованого
варіанта всюди відтворює 32 і 22 нижче точно й дає 0.3484. Саме це середнє є одним із п'яти наших
чисел, які не витримали зіткнення з доказами, а змішане визначення — це чому воно не
витримало: 0.351 не вдалося відтворити, а наше ж перше перевиведення змістилося до 0.3479, поки
визначення не було усталене. Це заміна, а не виправлення: ми публікуємо не виправлення до
величини, чиї викладки ми ще бачимо, а заміну для величини, чиї викладки більше не існують. Ніщо
на диску не каже нам, як 0.351 було обчислено спочатку, тож ми не можемо сказати, чи старе число
було хибним, чи було правильним за визначенням, якого ми не придумали, чи було обчислене по іншій
популяції — лише що ми не можемо його повернути. Тому скрипт і CSV, які ми публікуємо, є
авторитетом для цієї метрики в сильному сенсі: вони — єдиний авторитет; метрику обчислено один
раз, нами, і не звірено ні з чим зовнішнім. І розкид за визначеннями не є малим поруч з
ефектом — по трьох альтернативах, які ми спробували поряд з опублікованим визначенням, середнє
рухається між 0.3294 (без обрізання пробілів), 0.3680 (зі збереженням порожніх рядків) і
0.3479 (з дедублюванням) — розмах близько 11% від величини —
і це всього чотири варіанти, спробувані, а не перелічені вичерпно, — тож точкову оцінку 0.3484
слід читати як залежну від визначення. Розрив між популяціями розв'язаних і нерозв'язаних пережив
усі чотири варіанти, і саме це твердження ми насправді робимо. Середні по варіантах і діагноз
змішаного визначення, який пояснює, звідки взялося 0.3484, є у
memorisation_check.md.
Визначення чутливе, тож ось воно повністю. Додані рядки — це рядки патча з +, за винятком
заголовків файлів +++, з обрізаними пробілами, з відкинутими порожніми рядками. Додані рядки
золотого патча беруться як вони є, без дедублювання. Recall — це частка тих золотих доданих
рядків, які також трапляються серед доданих рядків патча моделі. Золото береться з кешованого
тестового спліту SWE-bench/SWE-bench_Lite; патчі моделі — це файли передбачень руки A. Те
обрізання пробілів не косметичне: без нього середнє змінюється з 0.3484 на 0.3294, а медіана — з
0.1667 на 0.0909. Число запам'ятовування, процитоване без його визначення, — це не число.
- Медіана 0.1667, середнє 0.3484.
- 32 зі 135 розв'язаних інстансів відтворюють золотий патч точно — але 22 з них мають однорядковий золотий патч, де будь-яке правильне виправлення обов'язково ідентичне.
- Контроль — це всі 88 оцінюваних нерозв'язаних-але-пропатчених інстансів (88 оцінюваних із 89) — випадки, де агент написав патч, який не пройшов. Він дає середнє 0.0995, тобто у 3.50x нижче, ніж множина розв'язаних, медіану 0.000, максимум 0.556; жоден не досягає 0.7. Метрика розрізняє; вона не просто вимірює «схоже на Python».
- Контроль спочатку був записаний як вибірка з 30 інстансів, і цю вибірку неможливо відновити: ні скрипт, ні seed, ні список id для неї не збереглися, тож ми її не повідомляємо і жодне твердження тут на ній не тримається. Це та сама «підмножина, якої, як з'ясувалося, не існує» зі списку п'яти вище; 88 оцінюваних інстансів — це перерахунок, а не та вибірка.
- Один інстанс неоцінюваний і виключений з обох популяцій, а не зарахований як нуль:
pytest-dev__pytest-5413, чий золотий патч не додає жодного непорожнього рядка, тож знаменник recall порожній. Це нерозв'язаний-але-пропатчений інстанс, тому контроль — 88 оцінюваних із 89.
Найсильніший одиничний підозрюваний і що ми можемо й чого не можемо показати
sphinx-doc__sphinx-8713 — єдиний інстанс, де збіг тотальний: доданий моделлю блок
побайтово ідентичний золотому, 7 із 7 рядків, той самий порядок, той самий відступ, те саме
галуження else:, той самий multiple=True. Обидва патчі зачіпають лише
sphinx/ext/napoleon/docstring.py, у тому самому hunk'у. Recall 1.000. Коментар справді є
серед тих семи рядків, відтворений дослівно. Якщо якийсь інстанс у цьому запуску й виглядає як
пригадування бенчмарку, то це він.
Цьому є звичайне пояснення, і при повторному огляді пояснення зафіксоване, а не постульоване — а
повторний огляд ще й урізав два наші власні твердження. Сусідній метод
_parse_parameters_section розташований на 2 рядки нижче місця редагування (редагування
замінює один рядок; def сусіда — ще двома рядками нижче). Файл на базовому коміті задачі
3ed7590ed411bd93b26098faab4f23619cdb2267, прочитаний із публічного репозиторію sphinx,
містить цього сусіда з тілом, посимвольно ідентичним сімом доданим рядкам, окрім одного токена — _('Parameters') там, де виправлення потребує
_('Other Parameters'). Виправлення — це тіло того сусіда, застосоване до методу поряд із ним.
Поділ, який тут важить, — між тим, що вже передав опис задачі, і тим, що могла дати лише файл.
Якщо зіставити сім доданих рядків із текстом issue рядок за рядком: issue передав моделі форму —
4 з 7 рядків трапляються в ньому дослівно, і так само вся структура потоку керування виправлення,
бо автор issue вставив обидва методи в баг-репорт. Файл дав коментар і аргумент. Саме ці два, і
лише вони, відсутні в промпті: пошук підрядка по всьому, що модель отримала перед своїм першим
кроком, знаходить multiple=True 0 разів і Allow to declare 0 разів в обох. Тож модель могла
скласти більшу частину цього блоку з самого issue; дослівний коментар і multiple=True — це те,
що пояснює файл.
Файл на тому базовому коміті, у публічному репозиторії sphinx, має ці два методи поруч, а сусід несе саме той коментар. Це читання кожен може повторити.
Із цією квитанцією йдуть чотири зауваги, викладені на повну ширину, а не залишені читачеві на пошук. Три з них — обмеження; перша була обмеженням, доки ми її не перевірили.
- Номери рядків: засвідчені заголовком, тоді звірені з файлом. Заголовок hunk'а
@@ -682,7прямо засвідчує доредакційну область 682–688; саме звідти зчитано місце редагування (685) іdefсусіда (687). Те, що тіло сусіда лежить на 688–694, спочатку було лише виведено з того, що тіло має сім рядків. Це більше не виведення: файл на базовому коміті цього інстансу3ed7590ed411bd93b26098faab4f23619cdb2267прочитано з публічного репозиторію sphinx, і рядки 688–694 — це те саме тіло, побайтово як процитовано. Діапазон засвідчено, і читач може повторити перевірку з самого лише коміта. - У записі немає жодного конкретного доредакційного читання. Запис запуску не зберігає доредакційного читання файлу, тож на жодне конкретне читання вказати не можна. Що встановлено — це властивість дерева вихідних текстів: сусід існував у файлі, поруч із місцем редагування, несучи ідентичний коментар — а не властивість якогось одного читання. Це чесна форма твердження, і її досить, щоб витримати висновок тут.
- Issue дав форму, тож файл пояснює менше, ніж натякає заголовок.
Автор issue вставив обидва методи в баг-репорт, тож сам issue дав 4 з 7 рядків і весь потік
керування виправлення, а внесок файлу зводиться до двох елементів: коментаря і
multiple=True. Ці два демонстровно відсутні в промпті — по 0 збігів підрядка, по всьому, що модель отримала перед своїм першим кроком. Отже, маємо таке: моделі був потрібен файл заради вмісту обсягом у два токени, файл поруч із місцем редагування містив саме їх, і ми можемо показати, що файл їх містив, не маючи змоги показати, що модель їх прочитала. Це правдоподібний виклад, а не доказ. - Один інстанс із 32. Це пояснює
sphinx-doc__sphinx-8713і не каже геть нічого про інші 31 точне відтворення, жодне з яких не оглядали в такий спосіб. Ми обрали цей інстанс, бо він був найпідозрілішим, а не бо він був репрезентативним, і пояснення, яке знімає найважчий випадок, не знімає інші 31 за виводом: решта 31 просто не досліджені. Чи покриває їх те саме невинне пояснення — відкрите питання, і ніщо в цьому дописі не слід читати як свідчення, що покриває.
Ми публікуємо методологію і повні числа, а не самі лише висновки.
Де насправді втрати
У базовій руці зі 165 невдач 76 узагалі не дали патча — 40 уперлися в налаштовані ліміти, 35
застрягли в повторюваному циклі, 1 (pylint-dev__pylint-5859) завершився зі статусом Submitted з
порожнім патчем. Чверть бенчмарку було втрачено через те, що агент повторював сам себе або
вичерпав бюджет, ще до будь-якого питання про те, чи зміг би він написати правильне виправлення.
Саме на цю втрату спрямована найкраща рука.
Анатомія таймінгу
Обчислено по всіх 300 файлах траєкторій руки A — по одному на кожен передреєстрований інстанс, кожен із них несе свої метрики запуску. Тут немає підмножини і немає відкинутого хвоста.
- Стінний час на задачу: середнє 264.2 с, медіана 176.6 с, 79,270 с сумарно. Обидва наведені, бо розрив між ними і є знахідкою: розподіл має довгий правий хвіст, і саме лише середнє описувало б типову задачу, якої не існує.
- LLM — це 95.4% стінного часу сукупно (75,645 із 79,270 с), а медіана по задачах — 95.5%. Harness — це майже ніщо.
- Медіана prefill 37.9 с, медіана decode 123.8 с.
- Виклики моделі: середнє 56.9, медіана 44.0. Це кількість кроків агента — кількість викликів моделі, які він фактично витратив. У записах існує також інша величина на задачу; ми наводимо кількість кроків, і ми кажемо, яке саме число наводимо, бо обидва числа захисні й не є однією й тією самою величиною.
- Completion-токени: середнє 11,107, медіана 7,092, по всіх 300 задачах. Попередня внутрішня
нотатка давала ~7,166, що близько до середнього по 225 задачах, які завершилися як
Submitted(7,179) — інша популяція. Величини по всіх 300 — ті, що вище.
Увесь цей розділ переміряно при n = 300, а не перенесено. Він заміняє попередній внутрішній набір величин — ~290 с стінного часу на задачу, ~85% частка LLM у стінному часі, медіани prefill/decode 40 с і 125 с, та ~54 виклики моделі — кожну з яких заміщують числа вище.
На цьому залізі вузьке місце — не harness. Це модель, а всередині моделі — decode.
Пропускна здатність обслуговування і виправлення попередньої чернетки
Виміряно на цьому залізі: конкурентність обмінює швидкість на потік на сукупну пропускну здатність,
і віддача від додаткових потоків значно менша, ніж стверджувала попередня внутрішня чернетка цього допису. Наведені нижче величини —
це сталі медіани по реальному навантаженню агента, на тій самій моделі й тій самій збірці
сервера, що їх використовували руки (Qwen3.6-35B-A3B-UD-Q4_K_XL, чотири слоти, 16384 токени
контексту на слот), і вони спираються на до 159,000 семплів decode. Ця кількість семплів — це
кількість спостережень decode, а не незалежних випробувань: усі вони походять із того самого
єдиного журналу того самого єдиного запуску на тій самій єдиній машині, тож велике n тут купує
точність усередині цього запуску і не купує геть нічого проти варіації між запусками, якої ми не
вимірювали.
| Конкурентних потоків | Decode на потік, стала медіана (tok/s) | семплів |
|---|---|---|
| 1 | 57.6 | 3,139 |
| 2 | 21.9 (лише форма) | 1,736 |
| 3 | 18.9 (лише форма) | 22,093 |
| 4 | 17.1 | 159,169 |
Рядки на 2 і 3 потоки читайте як форму, а не як величини того самого статусу, що й рядки на 1 і 4 потоки. За реального планування агента сервер майже весь час сидить на чотирьох слотах; два і три активні слоти — це перехідні режими під час розгону і спорожнення, і семплів відповідно мало — 1,736 для двопотокового кошика проти 159,169 для чотирипотокового, розрив приблизно дев'яносто до одного. Двопотоковий кошик — це також єдиний, де три оцінювачі розходяться більш ніж на 10% (21.90 / 21.98 проти зваженого за токенами 19.76). Наша власна квитанція каже, що вона взагалі не публікувала б 21.9 як двопотокову величину; ми її лишаємо, з поміткою, як форму кривої. 17.1 на чотирьох потоках — надійне число тут.
«Лише форма» мається на увазі на повну силу. Ми не стверджуємо 21.9 і 18.9 як вимірювання того, що цей сервер видає на двох і трьох конкурентних потоках; ми стверджуємо лише, що крива падає між рядками на один і на чотири потоки, і навіть це спирається на ті два рядки, яким ми довіряємо. Обидва перехідні рядки забруднені розгоном і спорожненням у спосіб, який ми не можемо відділити: слот, який запустився, але ще робить prefill, рахується активним, декодуючи при цьому нічого, і це хибне маркування сконцентроване саме в ті моменти, коли кількість слотів дорівнює двом або трьом. 22,093 семпли рядка на 3 потоки виглядають заспокійливо поруч із 1,736 рядка на 2 потоки, але вони взяті з тих самих перехідних режимів, і для цього рядка ми взагалі не звіряли три оцінювачі один з одним — його видима узгодженість не перевірена, а не підтверджена. Тому, кому потрібні справжні величини на 2 і 3 потоки, доведеться навмисно запустити сервер на двох і трьох слотах. Ми цього не робили.
Сукупна пропускна здатність при чотирислотовій конфігурації обслуговування, під якою працювали руки, становить 65 до 71 tok/s, а сумарне масштабування проти одного потоку — 1.15x до 1.31x. Обидва опубліковані як діапазони навмисно. Вони також спираються на один журнал, один запуск, одну машину, ніколи не повторені: жодної незалежної реплікації для жодної зі сталих величин не існує. По тому самому журналу прогнали чотири оцінювачі: 68.5 tok/s (сума медіан миттєвої швидкості decode по потоках), 70.6 (сума медіан по задачах із виключеним prompt eval), 64.9 (зважений за токенами по задачах) і четвертий, побудований зі стінного часу й підрахованих декодованих токенів, який нічого не перемножує і дає нижню межу 55.4 та найбільше відношення, 1.31x. Діапазон 65-71 не містить усіх чотирьох оцінювачів, і ми радше скажемо це, ніж дамо діапазону натякати, що містить. Оцінювач за стінним часом — єдиний із чотирьох, який нічого не перемножує і тому структурно найменш підозрілий — стоїть на 55.4, нижче за опубліковану підлогу, бо він зараховує час простою і prefill між сплесками decode до того самого стінного часу. Ми публікуємо 65-71 як діапазон пропускної здатності decode за названої конфігурації і 55.4 як нижню межу за стінним часом на тому самому запуску, і ми не стверджуємо, що ці дві величини вимірюють одне й те саме; читач, який хоче консервативнішу величину, має брати 55.4.
Найслабше місце нашої власної заміни, сказане, а не закопане. Наш трекер конкурентності рахує слот, який запустився, але ще робить prefill, як активний, хоча він нічого не декодує, а це зміщує медіану на потік донизу на величину, яку ми не можемо відділити від справжньої конкуренції за prefill, що, ймовірно, і пояснює розрив між пробою і сталим режимом у першу чергу. І конструкція, через яку старі 103.2 вводили в оману — сума медіан — не обмежується одним названим числом: два з трьох оцінювачів усередині діапазону 65-71 — 68.5 і 70.6 — є сумами медіан по потоках або по задачах, тож опубліковані підлога і стеля не є незалежними ані одна від одної, ані від дефекту. Сума медіан — не медіана суми, і обидві поділяють зміщення, а не беруть його в дужки. Ми не оцінили кількісно, наскільки велике те зміщення. Ми знаємо, що його знак неясний — хибне маркування активних слотів тисне медіану на потік донизу, конструкція «сума медіан» тисне сукупну величину догори — і ми не можемо звести їх одне проти одного тим, що записали. Одне заголовне число успадкувало б усе це мовчки. Діапазон — чесна форма, доступна нам; це не довірчий інтервал, і його не слід так читати.
Виправлення до попередньої чернетки цього допису — і воно вужче, ніж ми сказали спершу. Та
чернетка, ніколи не опублікована, містила чистішу сходинку: 59.2 / 41.2 / 31.8 / 25.8 на потік, сукупно
82.35 / 95.32 / 103.12, заголовне 1.74x. Нічого з цього ніхто не вигадав. Ті чотири величини
на потік походять із розгону в перших ста рядках журналу сервера, який чисто крокує через один,
два, три і чотири слоти, і на кожному кроці 31-токенний промпт генерує рівно 300 токенів. Це форма
навмисної проби ємності, хоча жоден скрипт і жодна нотатка не документують її як таку, тож
називати її навмисною — наш висновок із форми журналу. Ці чотири величини відтворюють колонку тієї
чернетки точно. Так само й сукупна арифметика не підміняла собою вимірювання: на чотирислотовому
кроці всі чотири слоти виконували ідентичну роботу і звільнилися в межах 0.4 мс одне від одного,
тож 103.45 tok/s справді було видано. Дефект — це підпис, а не арифметика. 103.2 — істинне
твердження про 300-токенну прогрівальну пробу і хибне твердження про машину під навантаженням
агента, а та чернетка подала його як друге. Промпт проби — 31 токен; реальний трафік на цьому сервері
несе промпти в тисячі токенів, тож під навантаженням слоти проводять значну частину кожного циклу
в prompt eval, не даючи декодованих токенів і крадучи обчислення в тих слотів, які декодують. Ось
цей розрив. Рядки журналу за кожним кроком і арифметика за 103.45 є у
receipt_staircase.md.
Виправлення успадковує обмеження того, що воно виправляє. Розгон трапляється один раз, у перших ста рядках одного журналу сервера; ті чотири величини — чотири поодинокі кроки, а не чотири розподіли, і 103.45 перераховане з того самого журналу, а не з незалежного запуску. Тож пояснення, яке ми пропонуємо для розриву — prompt eval при довгих реальних промптах — узгоджується з доказами і не є ними продемонстроване: ми не запускали пробу ще раз при реалістичній довжині промпта, щоб підтвердити, що розрив закриває саме prefill.
Застереження, яке важило раніше, важить і далі: це вимірювання пропускної здатності обслуговування за цієї конфігурації, а не міра того, скільки роботи агент виконує за секунду. Кожне число вище називає конфігурацію, з якої воно походить: чотири слоти, 16384 контексту на слот, власні модель і збірка сервера тих самих рук.
Що поле може взяти
- Проганяйте весь спліт і фіксуйте знаменник письмово. Часткові спліти з вигідним знаменником — типовий режим відмови в бенчмаркінгу агентів. 300 із 300, із хешованим маніфестом і знаменником, який не може зрушити, не коштує нічого, крім чесності.
- Запишіть планку першою і зробіть вибування арифметичним. Розв'язані плюс неоцінені нижче планки завершують руку без дискусії.
- Декларуйте свої конфаунди до запуску, а не після. Нашим була конкурентність, її задекларували заздалегідь із розтяжкою, і розтяжка спрацювала на п'яти задачах. Це можна повідомити лише тому, що це було записано першим.
- Оцінюйте по одному інстансу за запуск. Наша масово оцінена рука — це та, якій ми не можемо довіряти повністю, а причинами були три образи середовища, які не збираються, і репозиторії, чий власний крок встановлення падає.
- Проганяйте негативний контроль і перевірку на запам'ятовування і публікуйте їхню методологію, а не лише заспокійливий вивід.
- Вимірюйте невдачі, а не тільки перемоги. Наша найбільша окрема категорія втрат — чверть бенчмарку — була не «хибний патч»; це було «немає патча, агент застряг». Ці дві невдачі не мають нічого спільного і не мають однакового виправлення.
Ми не випускаємо агента. Що ми випускаємо — це маніфест задач, передреєстрацію, кількості по руках, протокол оцінювання, негативний контроль руки A і перевірку на запам'ятовування, а також README, який починається з описаного вище дефекту.
Квитанції: https://github.com/SynenergyAI/swebench-lite-300-receipts (CC BY 4.0).